「本地多Agent工作流 如何共享 Skill 和脚本 ?Codex、WorkBuddy、TraeWork」
现在很多人的电脑里同时装着 Codex、WorkBuddy、TraeWork,甚至 Claude Code、Cursor。用久了会出现一个很典型的浪费:同一个”图片重命名、生成索引、最后打 ZIP”的流程,每个 Agent 各写一套,最后电脑里躺着五六个版本。本文整理一套本地公共能力库的搭法——shared 放公共 Skill 与脚本,projects 放各自独立项目,并给出从文件夹共享到 Git、再到 MCP 的分阶段升级路径。
现在电脑里同时装 Codex、WorkBuddy、TraeWork,甚至 Claude Code、Cursor 的人越来越多。一开始感觉很好用:这个适合写代码,那个适合操作电脑,另一个适合长任务。但真正长期使用以后,很快会碰到一个问题:每个 Agent 都在自己的项目里沉淀 Skill、Prompt、脚本和工作经验。于是 Codex 写一套图片处理脚本,WorkBuddy 又写一套,TraeWork 换个项目时可能再重新写一次。同样一个“图片重命名、生成索引、最后打 ZIP”的流程,电脑里最后可能出现五六个版本。
这其实已经不是“哪个 Agent 更聪明”的问题,而是本地 AI 工作环境开始出现传统开发里很常见的问题:重复造轮子。
共用工具箱,不共用大脑
现在 Codex、WorkBuddy、TRAE 都已经逐渐支持 Skill、Rules、MCP、Agent 工作流等机制。方向其实越来越接近:模型负责判断和推理,Skill 负责告诉它工作方法,Script 负责执行重复动作,MCP 则负责连接外部工具和数据。
| 维度 | 核心结论 |
|---|---|
| 核心痛点 | 每个 Agent 各自沉淀 Skill 和脚本,同一个流程可能写出五六个版本 |
| 解决思路 | 不让几个 Agent 共用“大脑”,而是共用一套公共能力库 |
| 共享内容 | Skill、Script、模板与索引共享;记忆和运行配置各 Agent 独立 |
| 目录结构 | D:\AI_WORKSPACE\shared 放公共能力,projects 下各项目独立 |
| 加载方式 | 先读 SKILLS_INDEX.md,命中任务才读对应的 SKILL.md |
| 省钱关键 | 共享存储不等于共享上下文;能脚本化的动作不要停在 Prompt 里 |
| 版本管理 | 公共库建成 Git 仓库,改动可 git diff、可回退 |
| 升级路径 | 文件夹共享 → Git → skills-lock.json → 需要时再上 MCP |
| 现实参照 | OpenStarter 用 Turborepo + pnpm 把通用能力抽成共享 package,六个平台各取所需 |
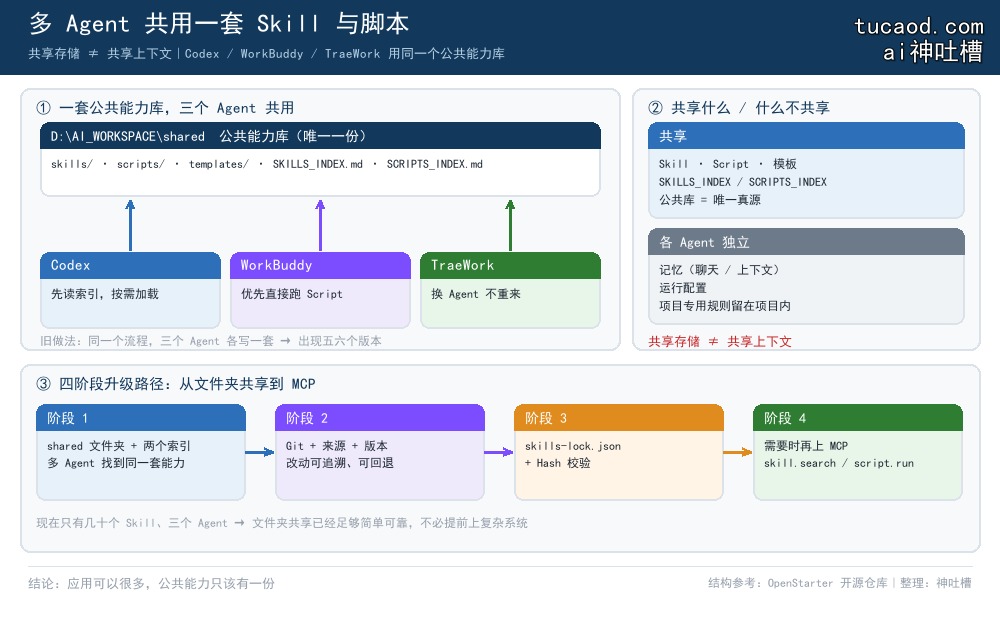
所以我的思路不是让三个 Agent 互相同步聊天记录,也不是建立一个复杂的“大脑中心”,而是在电脑里建立一个统一的公共能力库。
例如:
D:\AI_WORKSPACE\
├─ shared\
│  ├─ SKILLS_INDEX.md
│  ├─ SCRIPTS_INDEX.md
│  ├─ skills\
│  ├─ scripts\
│  └─ templates\
│
└─ projects\
   ├─ project-a\
   ├─ project-b\
   └─ project-c\
逻辑很简单:shared 是所有 Agent 共用的工具箱,projects 下面则继续保留各自独立项目。Codex、WorkBuddy、TraeWork 都可以做自己的项目,但遇到已经解决过的问题时,优先去 shared 里面找现成能力。
OpenStarter 启示:公共能力只留一份
最近看到的 OpenStarter 其实可以作为一个很好的参考。它本身不是多 Agent 调度平台,而是一个开源的全栈 SaaS Starter,目标是把认证、支付、国际化、SEO、后台、多端客户端等大量通用能力预先搭好,让开发者不要反复从零写基础设施。它采用 Turborepo + pnpm workspace 的 Monorepo 结构,把 Web、桌面端、移动端、浏览器扩展、CLI 和微信小程序放在同一个代码库中,同时把 API、认证、数据库、UI、Billing、AI、Analytics 等通用能力抽到 packages/ 中共享。
这个结构和本地 Agent 的问题其实很像。OpenStarter 不会让 Web 写一套认证、Desktop 再写一套、Mobile 又复制一份,而是尽量把公共能力放到共享 Package,各个平台只使用自己需要的部分。换成 Codex、WorkBuddy、TraeWork,同样可以理解为:
| 体系 | 多个入口 | 公共层 |
|---|---|---|
| OpenStarter | Web / Desktop / Mobile / 浏览器扩展 / CLI / 微信小程序 | 共享 packages/ |
| 本地 Agent | Codex / WorkBuddy / TraeWork / Claude Code / Cursor | 共享 skills + scripts |
OpenStarter 的项目根目录里还同时存在 AGENTS.md、CLAUDE.md 和 skills-lock.json。它的 Agent 说明文件会告诉 AI 项目的架构、目录、常用命令、编码规范、测试方法等,也就是让 AI 进入项目以后先理解“这个项目应该怎么工作”,而不是每次重新猜。
这一点非常值得借鉴。我们前面设计的 AI_PROJECT.md,本质上就是做类似的事情:项目只保存项目规则,公共能力则放在共享层。以后如果主要使用 Codex,也可以直接采用 AGENTS.md;其他 Agent 则通过自己的规则文件读取相同的项目原则,没有必要为每个 Agent 维护完全不同的一套项目知识。
OpenStarter 还有一个更值得注意的小细节:仓库里的 skills-lock.json 会记录 Skill 的来源、路径和计算后的哈希。当前文件中就记录了一个来自 vercel-labs/skills 的 find-skills Skill,并保存对应的 SKILL.md 路径和 computedHash。
这个设计对个人用户很有启发。我们现在没必要照搬完整 Skill Lock 系统,但以后公共 Skill 多起来以后,可以从最简单的 SKILLS_INDEX.md 逐步升级到 skills-lock.json——多记五个字段:
| 字段 | 记录什么 | 用来判断什么 |
|---|---|---|
| Skill 名称 | 这个能力叫什么 | 索引与检索 |
| 来源 | 自己写的、GitHub 下载的,还是某个项目沉淀出来的 | 判断可信度 |
| 版本 | 1.2 之类的版本号 | 判断有没有升级过 |
| 路径 | skills/xxx/ |
知道去哪里调用 |
| Hash | computedHash 计算值 |
有没有被某个 Agent 悄悄改过 |
这样就能知道:这个 Skill 是自己写的、GitHub 下载的,还是某个项目沉淀出来的;有没有被某个 Agent 悄悄修改;现在使用的是不是原来验证过的版本。
所以 OpenStarter 真正值得参考的不是它具体用了什么前端框架,而是它背后的一个思想:
应用可以很多,公共能力应该尽量只有一份。Agent 也可以很多,成熟 Skill 和 Script 同样不应该反复复制
Skill 不属于 Agent,属于工作流程
很多人会自然地形成这种结构:
Codex/skills/
WorkBuddy/skills/
Trae/skills/
这种结构隐含的意思其实是:Skill 属于 Agent。
但长期使用以后会发现并不是这样。比如有一个 Skill 是“扫描图片目录、统一命名、生成索引并打包”,这件事情跟 Codex 本身没有关系,也不属于 WorkBuddy,更不属于 TRAE。它真正属于的是你的工作流程。
所以关系应该改成:
                Shared Skills
                     │
        ┌────────────┼────────────┐
        │            │            │
      Codex      WorkBuddy     TraeWork
Agent 可以换,模型可以升级,但以前积累的工具和方法不应该因为换 Agent 就作废。
Skill 只分两类:项目专用与公共库
没有必要一开始就搞很复杂的状态系统。个人或者小团队阶段,Skill 只分两类就够了。
第一类是项目专用 Skill。例如某个品牌有特殊视觉规范、某个网站有特殊部署方式、某个项目有独有目录规则,这些能力就留在项目自己的 .ai/skills/ 里面。
第二类是公共 Skill。例如图片索引、文件批量重命名、ZIP 打包、网页截图、HTML 检查、网站 QA、文件去重等。这些能力与具体项目关系不大,就可以放到 shared/skills/。
判断标准可以非常简单:只有当前项目能用,就留项目;两个以上项目都可能复用,就考虑进入 shared。
共享存储,不等于共享上下文
这是必须注意的问题。如果以后公共库里有 100 个 Skill,而每次 Agent 一启动就把 100 个 Skill 全部读取,那么一定是在浪费 Token。
所以核心规则是:
共享存储,不等于共享上下文。
正确方式应该是:
- 先读索引
- 知道有哪些 Skill
- 判断当前任务需要什么
- 只读取相关 Skill
- 执行
而不是一进入项目就扫描整个共享库。
因此我会在 shared 里面固定放两个很小的文件:
SKILLS_INDEX.md 和 SCRIPTS_INDEX.md
例如 SKILLS_INDEX.md 只需要写:
## image-index
用途:为图片目录生成索引。
路径:skills/image-index/
什么时候使用:整理、盘点、交接图片时。
## website-qa
用途:检查网页基础问题。
路径:skills/website-qa/
什么时候使用:页面修改完成后。
Agent 每次只需要花很少上下文知道“这里有什么”,真正命中任务以后才去读取对应的 SKILL.md。
如果以后 Skill 数量越来越多,可以继续借鉴 OpenStarter 的 skills-lock.json 思路:索引负责让 AI 找能力,Lock 文件负责记录来源、版本和完整性。两者用途不同,不需要一开始就搞得很复杂。
省 Token 的是 Script,不是 Prompt
例如一个任务是:扫描 400 张图片,生成文件名、尺寸、目录和索引。如果没有现成脚本,每个 Agent 都可能重新理解需求、重新写 Python、重新调试、再重新执行。
如果已经有:
shared/scripts/images/make_index.py
以后 Agent 只需要知道:
用途:生成图片索引。
调用:python make_index.py <目录>
直接执行即可。甚至都不需要重新读取整段源码,只有脚本报错或需要修改时才打开源码。
所以长期使用 Agent 时,一个很重要的变化是:
能脚本化的重复动作,不要永远停留在 Prompt 里
Prompt 每一次都需要模型重新理解,而一个稳定 Script 可以重复执行几十次、几百次。
三个 Agent 怎么接入这套结构
其实不需要一开始就开发中央 MCP。现阶段,三个 Agent 只要都能够找到同一个 D:\AI_WORKSPACE\shared 就够了。
每个项目只需要放一个很小的规则文件,例如:
公共 Skill 和 Script 位于:
D:\AI_WORKSPACE\shared
开始任务前先读取:
SKILLS_INDEX.md
SCRIPTS_INDEX.md
只读取当前任务需要的 Skill。
禁止默认扫描整个 shared。
公共库已有能力时,不要重复创建。
这里也可以直接借鉴 OpenStarter 的做法:项目根目录维护 Agent 说明文件,让 AI 一进入仓库就知道项目结构、命令、规范和公共能力入口。OpenStarter 当前的 Agent 文档甚至直接列出了 Monorepo 结构、开发命令、测试、部署和代码规范。
如果某个 Agent 只能访问项目目录,还可以在 Windows 里通过 Junction 或 Symlink,让项目里的 .ai/shared 实际指向真正的公共目录。这样看起来 Agent 仍然在项目内部工作,但硬盘里实际上只有一套共享 Skill 和 Script。
只从大厂与 3A 流程拿两个思想
如果只是个人使用,没有必要照搬大公司的完整流程。真正值得借鉴的其实只有两个。
第一个是“公共工具不要重复制作”。这既是大型游戏开发的常见思路,也是 OpenStarter 这类 Monorepo 项目的核心逻辑之一:真正通用的能力抽出来,共同使用,不在每个应用中重复维护。OpenStarter 当前就把认证、Billing、Database、UI、国际化、Analytics 等拆成共享 Package,而不是分别塞进六个平台。
第二个是“先做一个完整样板,再批量生产”。比如要让 Agent 做 20 个页面,不要一开始直接做 20 个。先完成第一个,检查逻辑、视觉、目录、脚本和输出都没问题以后,再把方法固定下来,最后批量执行剩余页面。
这个规则对图片、页面、商品、数据整理、文件处理都适用,而且比搞一个复杂的多 Agent 调度平台更实用。
公共 Skill 什么时候才该产生
我不建议任何新 Prompt 一出现就立刻进入 shared。
更合理的流程是:先在项目自己的 .ai/skills/ 里面使用,真正执行过几次,确认有效,而且发现其他项目也能复用,再去掉项目特有内容,整理成公共 Skill,最后更新 SKILLS_INDEX.md。
这样 shared 才不会慢慢变成一个什么都有、但没人敢用的垃圾场。
以后再进一步,可以给公共 Skill 增加很轻量的来源记录:
| 字段 | 示例 |
|---|---|
| 名称 | image-index |
| 来源 | STRATA_HIMALAYA |
| 状态 | 已验证 |
| 版本 | 1.2 |
再往后 Skill 数量真的变多了,才有必要升级为类似 OpenStarter skills-lock.json 的机器可读记录方式。
公共库用 Git 管起来
这个成本很低,但很有用。
只需要给 D:\AI_WORKSPACE\shared 建立一个 Git 仓库即可,甚至只保留 main 分支就够。
这样某个 Agent 把已经稳定使用半年的 Skill “优化”坏了,可以先用 git diff 看它到底改了什么,必要的时候直接恢复。
如果未来再配合 Skill Hash,就可以进一步知道一个 Skill 是否和原来的验证版本一致。OpenStarter 的 skills-lock.json 已经采用了记录来源和计算哈希的方式,这也是为什么我认为它对多 Agent 本地工作区有参考价值。
随着 Agent 越来越自主,“可回退”和“知道它改过什么”反而会越来越重要。
什么时候才升级 MCP
我现在不建议为了看起来更 Agent 化,就立刻把所有 Skill 做成 MCP。
如果现在只有几十个 Skill、几十个脚本、三个 Agent 和几个项目,那么文件夹共享已经足够简单可靠。
等以后真正出现这些情况再考虑 MCP:Skill 和 Script 数量已经非常多,Agent 经常找不到正确工具,需要统一搜索,需要权限控制,需要调用数据库或远程服务,或者单纯文件目录已经明显影响效率。
到那时候,可以再把共享库封装成类似:
skill.search
skill.get
script.run
这样的统一接口。
所以整个系统其实可以逐步升级,而不是一次做到顶:
| 阶段 | 内容 | 解决什么 |
|---|---|---|
| 阶段 1 | shared 文件夹 + SKILLS_INDEX + SCRIPTS_INDEX |
多个 Agent 找到同一套能力,不再各写一套 |
| 阶段 2 | Git + Skill 来源 + 版本记录 | 改动可追溯,坏了能回退 |
| 阶段 3 | skills-lock.json + Hash + 自动检查 |
确认用的是不是验证过的版本 |
| 阶段 4 | 真的有需要时再做 MCP | Skill 多到找不到工具时,再上统一接口 |
OpenStarter 对我最大的启发也正是在这里:先把公共能力组织好,再谈更复杂的系统,而不是反过来。
给本地 Agent 的 16 条规则
- 先理解当前项目。
- 读取 AI_PROJECT.md / AGENTS.md。
- 查看公共 SKILLS_INDEX.md 和 SCRIPTS_INDEX.md。
- 优先复用已有 Skill 和 Script。
- 不默认扫描整个公共库。
- 只读取当前任务相关 Skill。
- Script 能执行时,不重新编写。
- 除非修改或排错,否则不要读取全部 Script 源码。
- 公共 Skill 不复制进项目。
- 项目特殊规则留在项目内部。
- 两个以上项目可能复用的能力,再考虑进入 shared。
- 批量任务先完成一个完整样板。
- 样板确认以后再批量执行。
- 不为了未来可能有用而提前建立复杂系统。
- 优先减少重复工作、重复上下文和重复 Token。
- 公共能力修改后必须可以通过 Git 回退。
换 Agent 不用从零开始
真正值得几个 Agent 共同继承的,并不是彼此的聊天记录,而是已经验证过的方法、脚本、工具、规范和经验。
OpenStarter 这种项目也说明了一件事:当代码规模开始扩大以后,真正提高效率的往往不是让每个入口都越来越强,而是把重复能力抽到公共层。对于 AI Agent 也是一样。
以后即使把 Codex 换掉,把 WorkBuddy 换掉,或者又增加新的 Agent,都不用重新从零开始。新 Agent 只要先读项目规则,再看公共能力索引,就知道:
这台电脑以前已经解决过哪些问题,以及这些能力应该去哪里调用。
这才是本地多 Agent 长期使用以后最有价值的积累。
文|神吐槽
文中 OpenStarter 相关的结构描述(Turborepo + pnpm Monorepo、AGENTS.md / CLAUDE.md / skills-lock.json 等文件)来自其开源仓库说明;目录结构与规则清单为本站整理版本,可按需替换成自己的路径。
- Codex、WorkBuddy、TraeWork 各自沉淀 Skill 和脚本,同一个”图片重命名、生成索引、打 ZIP”的流程会出现五六个版本,本质是本地 AI 环境里的重复造轮子。
- 作者提出的核心判断是”共享存储不等于共享上下文”:把 Skill 集中放进公共库只是第一步,真正省 Token 的是加载方式——先读索引,命中任务才读对应 SKILL.md。
- 建议在电脑里建一个 D:\AI_WORKSPACE 工作区,shared 目录放公共的 SKILLS_INDEX.md、SCRIPTS_INDEX.md、skills、scripts 和 templates,projects 下面继续保留各自独立项目。
- 开源全栈 SaaS Starter 项目 OpenStarter 是很好的现实参照:它用 Turborepo + pnpm workspace 把认证、支付、国际化、SEO、后台等能力抽到 packages/ 共享,而不是六个平台各写一遍。
- OpenStarter 仓库里同时存在 AGENTS.md、CLAUDE.md 和 skills-lock.json,前者让 AI 一进项目就知道架构与规范,后者记录 Skill 的来源、路径和 computedHash,用来判断有没有被改动过。
- Skill 只分两类:只有当前项目能用的留在项目自己的 .ai/skills/ 里,两个以上项目都可能复用的才考虑进入 shared/skills/,避免公共库变成没人敢用的垃圾场。
- 作者反复强调 Skill 不属于 Codex 也不属于 WorkBuddy,而属于你的工作流程:Agent 可以换、模型可以升级,但积累下来的工具和方法不应该因为换 Agent 就作废。
- 公共库最容易被忽略的成本是上下文:如果库里有 100 个 Skill 而每次启动全部读取,就是纯粹的 Token 浪费。正确做法是索引先行、按需加载,只读当前任务需要的部分。
- 真正省 Token 的是 Script 而不是 Prompt:Prompt 每次都要模型重新理解,而一个稳定脚本可以重复执行几十次、几百次,只有报错或需要修改时才打开源码。
- 整套方案可以分四阶段升级:文件夹共享加两个索引文件、再用 Git 加来源与版本记录、然后上 skills-lock.json 加 Hash 校验,最后等 Skill 数量多到找不到工具时再做 MCP。