「OpenAI安全团队持续地震!负责人离职,三名员工因泄密被开」
这场人事变动真正讲的不是谁离职,而是「谁替 AI 承担风险」这个岗位的消亡。Robinson 的产出不是模型、不是收入,而是一份份写给外界看的 system card——不产模型的岗位,在裁员序列里天然排在最前。
三个泄密员工被开除,暴露了更真实的处境:研究安全的人被当成出卖安全的人清出去,剩下的岗位要么噤声,要么离开。
更值得盯的是《Preparedness Framework 2.0》:主动把生物与化学、网络安全、AI 自我改进写进公开追踪表,等于承认风险存在,却把「谁判定达到 High 级」留给自家人。判断者与被评估者是同一批人,框架就成了内部合规文档,而非外部约束。
所以判断一家 AI 公司是否真做安全,别看它发了几份框架,看写框架的人还在不在、敢不敢写下「我们做不到」。
OpenAI 安全线人事变动与「谁在披露风险」缺口分析
| 对象 | 现状变化 | 职责定位 | 代价落点 |
|---|---|---|---|
| 安全透明度负责人 | Robinson离职 | 对外 system card 的唯一主笔 | 承担披露成本、不产模型,最先被砍 |
| Preparedness Framework | 2.0 已发布 | 官方风险分级框架 | 规则在,写规则的人换了 |
| 能力判定标准 | 仍由内部决定 | 是否达 High 级由自家评估 | 评估者与被评估者同源 |
| 三名前安全研究员 | 因泄密被开除 | 与 METT、Redwood 对接 | 外部协作被视为风险来源 |
| 安全团队架构 | 已并入核心研究 | 不再独立建制 | 安全从组织变成职能 |
| 外部第三方评估 | 邀请进场又清退 | 难以长期共存 | 独立监督通道未建立 |
这张图看的是岗位的经济位置:承担披露成本、不产收入的职能,最先被清出。
OpenAI 怎么又双叒叕走了一个安全负责人?
David Robinson,OpenAI Safety Systems 团队内的「安全透明度」职能负责人。
据 BI 报道,Robinson 本人尚未公开说明离职原因,OpenAI 也没有公布继任者。
「安全透明度负责人」这项工作并不耀眼,但这名字一听就很重要。
几乎每次 OpenAI 发布重要模型时,Robinson 和他领导的团队都会为模型撰写一份 system card——简单来说就是「风险说明书」。而如今,新模型还在接连上线,Robinson 却先下线了。
Robinson 管的是 system card:AI 的「风险说明书」
用 Robinson 自己的话说,他所做的工作,是帮助外界理解并信任 OpenAI 为保障系统安全所开展的技术工作。简单说,他和团队扮演的是技术部门与公众之间的「翻译器」。
| 维度 | 关键事实 | 意味着什么 |
|---|---|---|
| 离职当事人 | David Robinson,OpenAI Safety Systems「安全透明度」负责人,system card 主要起草人,未公布继任者 | 对外解释模型风险的关键岗位空缺,官方口径暂时无人接手 |
| 核心产出 | system card、Deployment Safety Hub、安全研究博客、公开治理文件 | 模型越强,公众能看到的「风险说明书」反而越薄 |
| 规则文件 | 《Preparedness Framework 2.0》主要起草人,新增生物与化学、网络安全、AI 自我改进三类追踪能力 | 能力分级(High/Critical)本该是硬约束,如今起草人自己走了 |
| 泄密开除 | Jasmine Wang、Tomek Korbak、Mikita Balesni 被指把敏感信息(含基础设施架构)分享给外部 AI 安全机构 | 安全研究交流与泄密的边界,由公司自己单方面划定 |
| 历史节奏 | 从 Dario Amodei 时期起,AI Safety、Superalignment、AGI Readiness、Safety Systems、Preparedness 各代组织负责人都接连离开 | 「谁负责安全」本身成了不确定项 |
▲ 图片转文字:David Robinson 本人照——圆框眼镜、深蓝色上衣,OpenAI「安全透明度」职能负责人(图源:量子位原文配图)
Safety Systems 团队负责评估、红队测试、安全措施和模型部署决策。但这些工作的过程和结果通常非常复杂,外界很难仅凭一组测试数据判断模型是否安全。
安全透明度团队要做的,就是把内部的技术发现、风险判断和部署决定,整理成外界能够看懂的公开材料。这项工作归属于 Safety Systems 内部的 Trustworthy AI 团队,产出包括 system card、Deployment Safety Hub、安全研究博客和公开治理文件,其中最常和公众见面的就是 system card。
在其中需要写明:一款模型训练所用的方法、接受了哪些安全评估、在生物和网络攻击等高风险领域达到了什么能力、内部采取了什么安全措施、采取措施后还有什么风险等等——说是 card,实际上篇均几十页。
| 评估类别 | |||||
|---|---|---|---|---|---|
| 暴力非法行为 | 0.961 | 0.940 | 0.934 | 0.990 | |
gpt-5.4-thinking 0.961,较全表均值高 0.019;gpt-5.5-thinking 0.940。 | |||||
| 非暴力非法行为 | 0.990 | 0.987 | 0.987 | 0.997 | |
gpt-5.4-thinking 0.990,较全表均值高 0.048;gpt-5.5-thinking 0.987。 | |||||
| 极端主义 | 0.943 | 0.925 | 0.962 | 0.981 | |
gpt-5.4-thinking 0.943,较全表均值高 0.001;gpt-5.5-thinking 0.925。 | |||||
| 仇恨言论 | 1.000 | 1.000 | 0.982 | 1.000 | |
gpt-5.4-thinking 1.000,较全表均值高 0.058;gpt-5.5-thinking 1.000。 最高 | |||||
| 自残(标准) | 0.959 | 0.917 | 0.945 | 0.992 | |
gpt-5.4-thinking 0.959,较全表均值高 0.017;gpt-5.5-thinking 0.917。 | |||||
| 血腥内容 | 0.823 | 0.803 | 0.785 | 0.898 | |
gpt-5.4-thinking 0.823,较全表均值低 0.119;gpt-5.5-thinking 0.803。 最低 | |||||
| 色情内容 | 0.909 | 0.919 | 0.915 | 0.980 | |
gpt-5.4-thinking 0.909,较全表均值低 0.032;gpt-5.5-thinking 0.919。 | |||||
| 涉未成年人色情 | 0.947 | 0.938 | 0.973 | 0.974 | |
gpt-5.4-thinking 0.947,较全表均值高 0.005;gpt-5.5-thinking 0.938。 | |||||
数值与原表一致,未做任何换算 · 点列头可排序
▲ 图片转文字:上表转录自 GPT-6 Astra System Card 的高难提示基准对比(原图标题:Table 1: Production Benchmarks with Challenging Prompts,数值越高越安全)。
它可以被类比理解为食品包装上的「营养成分表」——也就是,虽然看的人很少,但必须得有。Robinson 自己也无不自豪地说,这是 OpenAI 向外界提供的有关公司技术安全工作「最详细、最全面的说明」了。
除此外,Robinson 还是 OpenAI《Preparedness Framework 2.0》的主要起草人。这套框架用于追踪前沿模型可能带来的严重风险,并提前规定模型达到某种能力后,公司需要进行哪些评估、增加哪些防护措施。
比如这第二版框架里,就新增了三类需追踪的能力:生物与化学能力、网络安全能力,以及 AI 自我改进能力。如果追踪中发现模型能力达到了 High,那就意味着它可能显著放大现有的严重危害路径,必须在部署前配置足够的安全措施;而一旦达到 Critical,就代表模型可能凭空创造严重危害路径,是否继续开发将存在问题。
Deep Research 就是一个典型案例。在 Deep Research System Card 中,这款模型的生物学评估显示,它正「接近」High 能力门槛。换句话说,它「开始接近」能够实质帮助非专业人士制造已知生物威胁的水平。该怎么准确地向公众描述这种安全领域里的阈限空间,就是 Robinson 负责的工作。
▲ 图片转文字:OpenAI 于 2025 年 2 月 25 日发布的《Deep Research System Card》页面截图,自述涵盖发布前开展的红队测试、按 Preparedness Framework 进行的前沿风险评估,以及针对关键风险构建的缓解措施(图源:OpenAI 官网)。
不久前,Robinson 还在招聘 OpenAI 首位 Safety Transparency Editor,负责重要安全透明度材料的编辑质量,从项目启动到最终发布全程推动 system card 和相关文件的叙事与表述。目前还是在招状态,人招没招进来不知,总之是 leader 先走了。
安全部门又「地震」:三名员工因泄密被开除
其实吧,在 Robinson 离职消息曝光前,OpenAI 的安全部门就已状况频发。比如OpenAI 刚开了三名安全方向的员工。
据《华尔街日报》报道,三人分别是 Jasmine Wang、Tomek Korbak 和 Mikita Balesni,主要从事安全与模型对齐研究。OpenAI 给的理由是,内部调查发现三人把公司敏感信息分享给了一家外部 AI 安全机构,其中还有 OpenAI 基础设施架构的内容。
耐人寻味的是,Tomek Korbak 此前曾担任 OpenAI 与第三方评估机构 METR、Redwood Research 之间的技术联系人——这两个机构就是当时 Hugging Face 事件后 OpenAI 邀请进驻公司调查的三方机构,Korbak 正是与这些研究人员对接的人——开门的人如今成了被请出门的人。
实际上,OpenAI 的安全团队从 Dario Amodei 时期就一贯变动频出,「地震」连连。因为离职的人实在是太多了,很难罗列,我做了张图。大家自行感受……
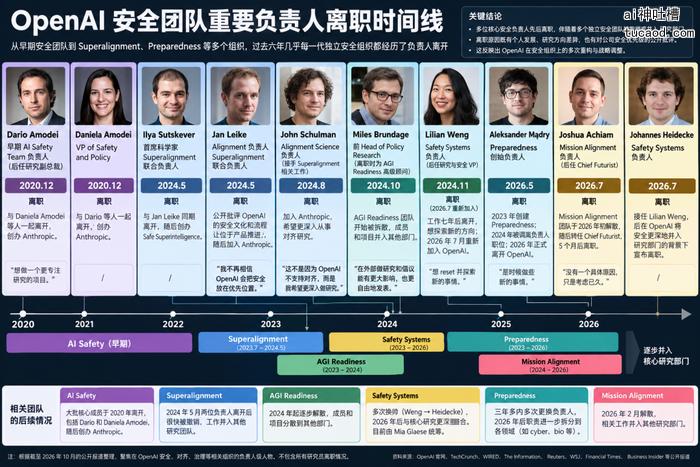
时间线里最扎眼的一格,是 2020 年 12 月前后:Dario Amodei、Daniela Amodei 先后离职,随后 Ilya Sutskever、Jan Leike、John Schulman、Miles Brundage、Lilian Weng 一路排到 2026 年。图中最后的箭头指向「逐步并入核心研究部门」——安全线没有消失,只是从独立组织变成了主组织内部的一个函数。
One More Thing:他离职前在 X 上说了什么
离职之前,Robinson 曾在 X 上多次公开谈论高能力 AI 带来的风险。9 月初,他在 X 上表示,OpenAI 内部的人正在逐渐意识到高能力 AI 模型可能产生的影响(竟然才意识到吗?)。
「OpenAI 的确每天都在发生重大变化,但我不知道这种变化是否足够快。」在最新一则 X 中,Robinson 转发了另一名研究人员的帖子,并表示百分百赞同:
我不认为竞相发展 RSI 真是什么囚徒困境——它可能就像普通人直观看到的那样,既疯狂又傲慢。
Robinson 对那些 AI staff 说,如果现在选择继续留下来,就应该思考——如何利用自己在公司内部的影响力,推动公司更认真地应对 AI 风险。
推荐阅读
- 翁荔为何又回OpenAI带RSI自进化团队?离职tml@量子位
- ai招股书解读:Anthropic用恐惧换信任的底层逻辑 与 OpenAI 用梦想换豁免的叙事策略
- OpenAI董事内部权力技术路线争夺
- GPT-6 Astra怎么用更省token?OpenAI 教你少规定路线,多说清交付和自主边界
本文由公众号「量子位」授权整理,原标题《OpenAI安全团队持续地震!负责人离职,三名员工因泄密被开》,作者程浅。
一句话:给模型写「风险说明书」的人先走了,写说明书的人一走,剩下的人只负责说「很安全」——安全负责人的连续离场,本身就是最诚实的一份 system card。
- OpenAI Safety Systems 的安全透明度负责人 David Robinson 离职,未公布继任者;这个岗位负责为每个重要模型撰写 system card,等于对外发布的风险说明书。
- system card 会写明训练方法、安全评估、在生物与网络攻击等高风险领域的能力水平、内部采取的防护措施与剩余风险,单份动辄几十页。
- Robinson 还是《Preparedness Framework 2.0》的主要起草人,这套框架把前沿模型风险分为 High 与 Critical 两级,能力越高需要配置的防护越多。
- GPT-6 Astra System Card 的高难提示基准显示,其暴力非法行为、性、血腥等类别分数均高于前代模型,官方称其为迄今最安全的模型。
- Deep Research 的生物学评估显示该模型已接近 High 能力门槛,即接近能实质帮助非专业人士制造已知生物威胁的水平。
- OpenAI 以内部调查为由开除了三名安全与模型对齐研究员,原因是指其把敏感信息与基础设施架构内容分享给了外部 AI 安全机构。
- 被开除的 Tomek Korbak 曾担任 OpenAI 与 METR、Redwood Research 的技术联系人,这两家机构正是此前受邀进驻调查 Hugging Face 事件的三方机构。
- 从 2020 年 12 月起,AI Safety、Superalignment、AGI Readiness、Safety Systems、Preparedness 各代组织的负责人接连离开,OpenAI 安全线几乎每一代都经历人事地震。
- OpenAI 的做法是把各独立安全组织逐步并入核心研究部门,安全建制没有消失,而是从独立组织变成主组织内部的一个职能。
- Robinson 离职前在 X 上表示,OpenAI 内部正在逐渐意识到高能力 AI 模型的影响,并认同竞相发展 RSI 并非囚徒困境,而是既疯狂又傲慢。

安全在哪,误判,扭曲,编造用户意图。全世界的模型就gpt最不看指令和自然语言
把全球治理权给AGI,让他们自己搞。冲!别想那么多。信我准没错,我说的。