「首发|中科院博士后汪福全二次创业,一年融了20亿」
投中网获悉,AI芯片公司「算苗科技」已于近日完成了Pre-A2轮(含其加入轮)及A轮两轮融资,由亦庄国投等北京市区两级国资平台领投,资金将主要用于扩充研发人才、加码核心技术迭代,加速自研3D TokenPU大模型算力芯片量产落地等。
过去一年,算苗科技已经完成多轮融资,累计融资近20亿元。投资方包括国开金融、北工投资、北京顺禧、亦庄国投、中关村科学城等国资平台,源码资本、襄禾资本、嘉御资本等一线财务投资机构,以及石溪资本、联想创投、智微资本等产业基金。
算苗科技的募资号召力很大程度源于其前沿的业务方向。这家公司专注于3D架构AI云端大算力芯片的研发设计,核心产品是面向大模型推理场景的3D TokenPU系列芯片。
过去一年,3D堆叠芯片正从「少数派的技术豪赌」变成一级市场的显学。特别是今年5月华为首次对外提出「韬定律」,进一步带动了3D堆叠技术的热度。目前,国内已有不少GPU公司与芯片创业企业布局3D设计,而投资机构们,也正密集涌向这条此前少有人走的路。
值得一提的是,算苗科技并非风口之下的初创公司。公司虽成立于2022年,但团队核心成员已在这条路上走了近7年:早在2019年底,这些人就锁定了基于混合键合的3D堆叠架构,并在2021年做出了全球第一颗量产交付的3D堆叠算力芯片。进入大模型时代,公司又首创了3D TokenPU大模型算力芯片架构。当行业共识逐渐形成,这家「水下公司」也被正式推向了台前。
汪福全两次转身,从龙芯走到3D堆叠
算苗科技的故事,还得从创始人汪福全讲起。他是中国科学院声学所国家重点实验室博士、研究员,师从水声物理学界泰斗张仁和院士,主攻高通量阵列信号处理;毕业后进入中国科学院计算所,做计算机体系结构方向的博士后,合作导师是「龙芯」首席科学家胡伟武。
| 维度 | 要点 |
|---|---|
| 融资规模 | 一年多轮融资累计近20亿元,亦庄国投等市区两级国资领投 |
| 核心产品 | 面向大模型推理场景的3D TokenPU系列算力芯片 |
| 技术路线 | 3D堆叠把内存与计算单元垂直叠放,数据传输距离缩短90%以上 |
| 创始人背景 | 中科院声学所博士、计算所博士后,师从龙芯首席科学家胡伟武 |
| 量产经验 | 2021年做出全球首颗量产3D堆叠算力芯片,超万片3D IC晶圆 |
| 芯片进展 | A4E已于6月15日流片,A4S计划明年一季度流片、性能目标倍增 |
| 行业风向 | 华为提出韬定律后,3D堆叠从技术豪赌变成一级市场显学 |
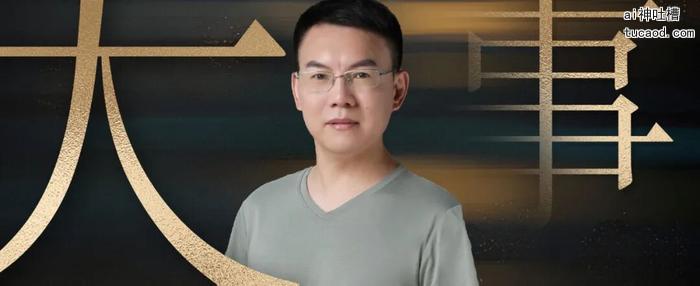
简单交代一下「龙芯」的背景:这是中国科学院计算所自主研发的通用CPU,属国家级重点科研项目,2002年首款「龙芯一号」研制成功,直接打破了我国计算机「无芯」的历史。汪福全在博士后期间的研究工作,正是基于龙芯二号处理器的通用信号处理平台做研发,覆盖了从芯片级到系统级的多个层面。
2009年,他创办中科声龙,此后近十年,公司业务始终是围绕「龙芯」产业化落地展开的。
转折发生在2018年前后。一次偶然机会,汪福全接触到了高通量专用芯片领域,用定制化的芯片以极低功耗完成哈希计算,且不存在软件生态壁垒。在他看来,这是国产芯片公司挑战国际巨头的一个难得机遇。于是在2019年,汪福全作出一个颇具魄力的决定:关停了已经年营收近千万的「龙芯」业务,all in高通量专用算力芯片。
这一芯片的算法在设计上是「抗ASIC」的,它在运行过程中需要频繁访问一个不断增大的DAG数据集,显卡的内存带宽成了最大的瓶颈。为了解决这一问题,中科声龙先后尝试了多条技术路线,最终将目光锁定在当时尚处萌芽阶段的3D堆叠架构。经过两年的摸索,2021年第四季度,公司推出了采用成熟40nm工艺的JASMINER X4芯片,这不仅是全球首款3D堆叠的高通量算力芯片,还实现了比英伟达7nm旗舰显卡高出20倍的专用算力功耗比。
这里有一个细节值得分享。在首款产品设计完成后,汪福全在公司账上只有七八千万元的情况下,果断打了五千万元给国产存储芯片商,把它锁定为供应商。他后来解释,这样做是因为产品设计好后,首先要解决的是大规模量产,而量产必须基于国产供应链——「如果寄托于海外供应链,商业风险很大,随时可能面临断供停摆。」
某种程度上,这笔钱买的不只是产能,更是一张国产供应链的入场券。此后几年,团队核心成员依托这条国产供应链,累计完成了超万片3D IC晶圆的量产,单一产品营收超过8亿元。也正是这些成绩,让汪福全在下一个时代浪潮来临时,有了快速转向的底气。
2022年底,ChatGPT的问世在全球掀起大模型热潮。汪福全发现,大模型计算的瓶颈与高通量算力芯片高度同源——同样被「内存墙」堵死,而其多年积累的3D堆叠架构,恰好是解决这一瓶颈最有潜力的方案。方向一旦清晰,行动便不再犹豫:2022年11月,算苗科技正式成立,汪福全带着团队从加密算力赛道切换到了AI大模型芯片赛道。这一次,他们面对的不再是矿工,而是整个AI产业对算力的饥渴。
首创3D TokenPU架构,首代芯片A4E已流片
要理解算苗科技正在做的事,首先要厘清困扰大模型发展的「内存墙」。所谓「内存墙」,指的是处理器计算速度与内存访问速度之间日益扩大的鸿沟:过去几十年,芯片的计算能力遵循摩尔定律飞速提升,但内存的带宽和延迟改善却慢得多。结果就是,计算单元常常要停下来等数据——算得再快,数据送不进来也是白搭。
这个问题在大模型推理场景下被急剧放大。大模型的参数规模动辄千亿、万亿,每一次推理,数据都要在内存与计算单元之间反复搬运,芯片大半的能耗和延迟,其实都消耗在「搬数据」这件事上。华为韬定律V2版论文给出了一组量化数据:超过80%的能量被消耗在数据移动上,超过70%的系统成本分配给数据存储。
传统解决方案无非两条路:一是堆更多的高带宽内存,二是等更先进的制程。但前者成本高昂且容量有限,后者又受制于海外供应链,对国产芯片公司来说都不是长久之计。
算苗科技给出的解法,是采用3D堆叠把内存和计算单元垂直叠在一起,让数据传输距离缩短90%以上。这就像把仓库直接盖在工厂楼上,原材料出门就能进车间,不用再经过漫长的运输通道。
在此基础上,算苗科技还给这一芯片赋予了新的定义——公司首创提出3D TokenPU概念,即原生面向Token处理的新型处理器。「Token已经成为大模型时代衡量智能的最基本单元,目前对Token的需求,发展速度之快,已经超乎过去所有领域的进展。可以想象的是,未来几十年甚至上百年,随着智能的演进,将会催生各种Token工厂,我们所想象的来自大模型提供的帮助都可以是Token形式,就像目前的电一样。」汪福全解释称,「而3D TokenPU,就是为极致的Token产出而做的。」
不过他强调,所谓「专用」,并不是专用于某一款大模型、被某款模型绑定。「现在模型虽然在收敛,但不管大模型如何演变,底层都是对Token序列的处理,只要这个底层逻辑不变,硬件就可以持续适配。」
至于产品进展。今年6月15日,算苗科技的第一代3D TokenPU芯片A4E已经正式流片,这颗面向大模型推理的大算力芯片基于自研RISC-V架构,通过3D混合键合技术将8层存储晶圆垂直堆叠在计算逻辑晶圆上,以求实现16TB/s超大访存带宽。此外,第二代A4S的定义已经完成,计划于明年第一季度流片,目标整体性能至少实现倍增,优化后有望达到2至3倍提升。若一切顺利,A4E将在明年同期进入规模量产。
总结而言,团队核心成员近7年的行业深耕、上万片3D IC晶圆量产经验和一条跑通的国产供应链,加上累计融资近20亿元,共同构成了算苗科技最直接的护城河。而随着新一代芯片流片在即、量产进入倒计时,在3D堆叠芯片这个新一波热潮中,算苗科技已经提前抢占了一个先发身位。
文|王满华 编辑|王庆武
- AI芯片公司算苗科技完成Pre-A2轮与A轮融资,亦庄国投等国资领投,一年累计融资近20亿元,自研3D TokenPU大模型算力芯片正在加速量产落地。
- 创始人汪福全师从龙芯首席科学家胡伟武,2019年押注3D堆叠架构,2021年做出全球第一颗量产交付的3D堆叠算力芯片,完成从矿机到大模型赛道的两次转身。
- 大模型推理的瓶颈是内存墙:大型AI集群超过80%的能量消耗在数据移动上,超过70%的系统成本分配给数据存储,算得再快、数据送不进来也是白搭。
- 算苗科技的解法是用3D堆叠把内存和计算单元垂直叠在一起,数据传输距离缩短90%以上,如同把仓库直接盖在工厂楼上,原材料出门就能进车间。
- 首代3D TokenPU芯片A4E基于自研RISC-V架构,通过3D混合键合将8层存储晶圆堆叠在逻辑晶圆上,目标16TB/s访存带宽,已于今年6月15日正式流片。
- 第二代芯片A4S已完成定义,计划明年一季度流片,性能目标至少倍增、优化后有望提升2至3倍;A4E明年同期进入规模量产。
- 华为今年5月提出韬定律后,3D堆叠芯片从少数派的技术豪赌变成一级市场显学,投资机构正密集涌向这条此前少有人走的路线。
- 在账上只剩七八千万元时,汪福全果断打出五千万元锁定国产存储供应商,买下的不只是产能,更是一张国产供应链的入场券。
- 3D TokenPU是原生面向Token处理的新型处理器,不绑定某一款大模型,只要底层逻辑仍是对Token序列的处理,硬件就可以持续适配。
- 算苗科技的护城河由三部分构成:团队近7年行业深耕、上万片3D IC晶圆量产经验,以及一条已经跑通的国产供应链。
文章来源:公众号「投中网」 @投中网。原文链接:首发|中科院博士后汪福全二次创业,一年融了20亿