一文讲清向量搜索:把资料上传给 AI 之后,它到底是怎么找到答案的?
向量检索的门槛不在算法而在工程:这篇从「关键词检索为什么失效」讲起,把文字变成坐标、百万级数据怎么快速找到最近的几个,一路讲到 IVF/HNSW 索引,最后落到四类方案的选型对照。要搭 RAG 或知识库的团队,可以先拿它当全景地图,再决定自建还是用现成服务。
给读者的实用建议:先建立「语义距离」这个核心直觉,再按自家数据规模对号入座——十万级文档用 pgvector 最省事,已有 Elasticsearch 集群的直接加向量能力,真要大规模分布式再考虑 Milvus。选型的终点不是性能榜单,而是业务场景和自身运维能力。
| 维度 | 文章做法 | 我们的判断 |
|---|---|---|
| 原理讲解 | 从关键词失效讲到 Embedding、相似度与 ANN 索引 | 到位:先立直觉再讲机制,入门即用 |
| 索引取舍 | IVF 分组与 HNSW 分层图,都讲清速度/召回平衡 | 清晰;实战还要看内存占用与构建耗时 |
| 选型建议 | 四类方案横向对比,按规模与运维能力分流 | 务实:不唯性能论,终点落在业务场景 |
我们在开发Agent、企业知识库RAG的时候,总有一个绕不过去的坎
如何从大量信息中,找到和当前问题最相关的那一小部分内容
这也是RAG,Agent memory 中非常核心的一步 : 检索
传统软件开发 我们都是通过关键字,数据库SQL来检索数据。但是到了自然语言场景,这种方式很快就遇到了问题。假设知识库里有一句话:订单支付成功后 7 天内,可以发起退款申请。
用户问的却是:买完东西多久还能退? 从文字来看,这两句话没有什么相同的词语,关键字查询在这里就失效了,
但是我们一眼就能看出,这两句话表达的是同一个事情
那么,计算机怎么知道这两句话意思接近?
这里我们就不得不提到 向量 ,本文会系统的讲解向量这个词的含义,以及向量数据库的分类和选型
向量到底是什么
我们可以先把向量理解成一组有顺序的数字,我们来看一下如何用数学来表达向量,
| 维度 | 要点 |
|---|---|
| 解决的问题 | 自然语言场景关键词检索失效,需按语义找到最相关内容 |
| 核心思路 | Embedding 模型把文本转成多维向量,语义相近则空间距离近 |
| 相似度计算 | 余弦相似度(文本场景最常用)、点积、欧氏距离 L2 |
| 大规模检索 | 逐条比较不可行,靠 ANN 近似最近邻加向量索引缩小范围 |
| IVF 原理 | 先聚类分区,再在最近区域精搜,用 probes 平衡速度与召回 |
| HNSW 原理 | 多层图结构:上层少节点快速逼近,下层节点多精细搜索 |
| 选型四类 | 专用向量数据库、pgvector 扩展、搜索引擎加向量、FAISS 检索库 |
| 选型结论 | 看数据规模、索引能力、元数据过滤与运维成本,终点是业务场景 |
例如 一个二维向量 [3,5], 三维向量 [3,5,8], 多维向量 [3,5,8,1,1,….]
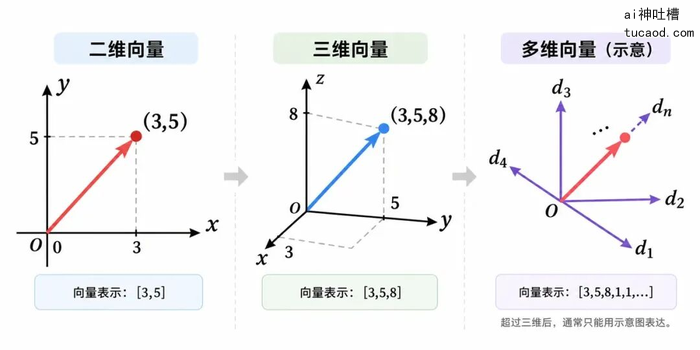
我们现在知道 向量可以用一个多维的数组坐标来表示,我们要如何将文字转换成一个 数字坐标呢,这里就不得不提到 向量模型 ( Embedding),文字输入到向量模型,模型就会输出一个多维的数组坐标。
如果 向量模型 输出 768 个数字,我们就称它为 768 维向量。如何输出1000个数字,我们就说它是1000维的向量模型,我们已经没办法直接画出这样的空间,但计算机仍然可以通过算法来比较这些数字,计算向量之间的距离、夹角和点积。如果我们把这些多维的向量坐标映射到一个平面上,你大概可以看到下图的样子,
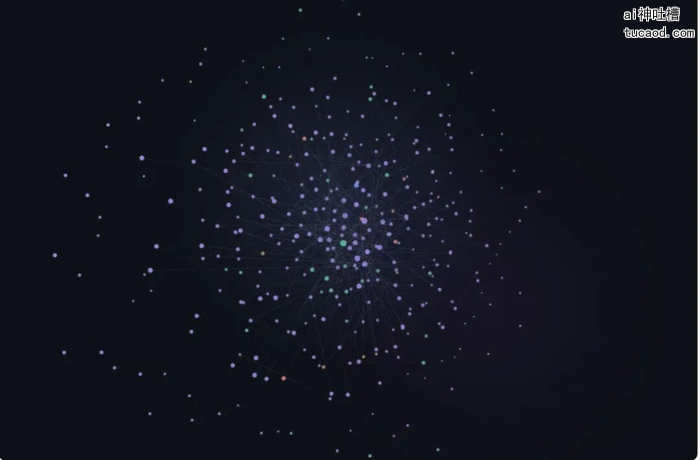
图中的每一个点,就代表一段文字,向量提供了一种把内容转成可计算表示的方法。 文本原本是字和词,经过模型转换后,就能用数学运算比较它与其他文本的关系。
图中距离越近的点,就表示语义越相近,为什么会这样呢,它的机制是什么?
这并不是一个向量就具备了这种能力,关键在于 Embedding 模型是怎么训练出来的。
在训练过程中,模型会学习一种表示方式,让语义相关的内容在向量空间里靠得更近,不相关的内容离得更远。
我们不需要去关心 模型是怎么做到这件事情的,我们只需要知道 模型会给出一组数字,在多维空间里面就是一个多维的数组坐标,从空间来看就是一个小点,这个点和相近的点 语义相似度很高。
向量模型会把对象的特征和语义编码到向量中,搜索时比较查询向量和已有对象向量之间的相似程度,从而找到最接近的内容。
这样一来,原来非常难处理的自然语言检索问题,就变成了一个数学问题:
在很多向量里面,找到距离当前向量最近的几个。
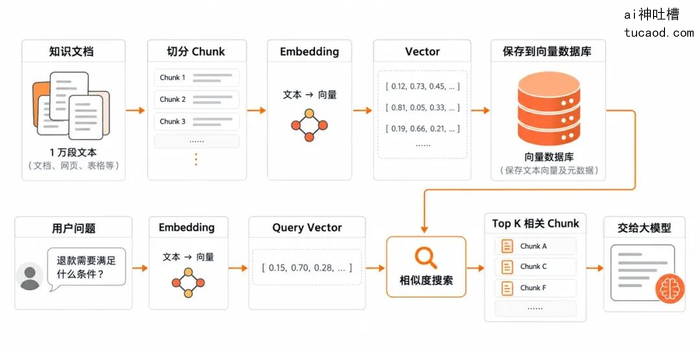
比如知识库里有 100 万段文本。我们事先把它们全部转换成向量:
文档 A → [0.12, 0.73, ...]
文档 B → [0.81, 0.05, ...]
文档 C → [0.19, 0.66, ...]
……
用户提出问题:
“退款需要满足什么条件?”
我们再把问题转换成一个向量:
Query → [0.15, 0.70, ...]
接下来就可以寻找 距离用户问题 最近的几个向量,查完返回的结果就是和当前问题语义最接近的几段文档。
整个 核心检索过程其实就是:
看到这里 ,我们就很自然的想到点和点之间的距离是如何计算的,怎么判断两个向量之间到底近不近,
下面是最常见的有几种方法:
-
Cosine Similarity,余弦相似度
-
Dot Product,点积
-
Euclidean Distance,欧氏距离,也就是 L2。
这里我们不去钻研具体数学公式,可以简单理解为,它们使用不同的方法比较两个向量之间的接近程度。
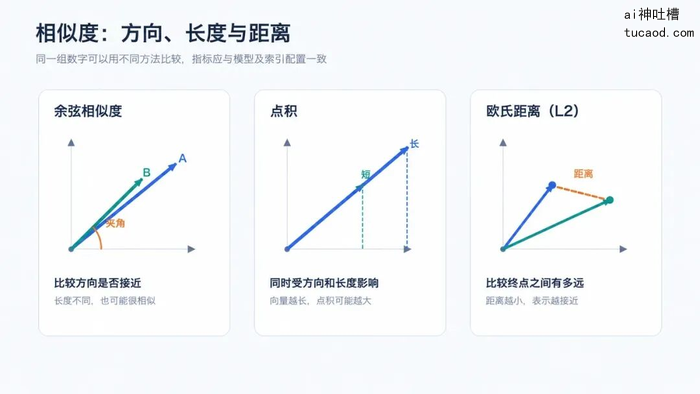
其中余弦相似度在文本 Embedding 场景中非常常见,它更关注两个向量的方向是否一致,如果两个向量方向越接近,通常意味着语义越相似。
于是整个问题就进一步变成:
给定一个 Query Vector

从 100 万个 Vector 中

找到相似度最高的 10 个
如果只有几十或者几百个向量,这件事其实很简单,全部比较一次就行,但当数据变成100万,甚至1000万,1个亿的时候,你还能一条条的去比较,然后找到最近的10个吗
于是我们就进入了向量数据库真正需要解决的问题。
向量怎么保存和检索
保存向量这件事情并不复杂,向量模型把文本内容向量化之后,返回的是一堆数字,不管你把这些数字保存的文件中,还是数据库表中的一个字段都可以,但是 保存这个向量,不仅仅是保存这串数字,还有其他额外的信息。
一条用于知识库检索的数据,通常会包含下面这些内容:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
我们在保存向量的数据的时候,还需要考虑后续的更新,删除如何处理,保留原文的引用方便后续召回,以及来源和业务信息,方便后续溯源,处理业务隔离和权限隔离。
因此我们在保存向量数据的时候,往往会保留很多的元数据信息。
向量是如何检索的呢
最简单的办法,就是把用户的问题转换成向量,然后和我们保存的数据 一条一条的比较,计算他们之间的距离,最后找出距离最近的几条数据,这个对于小批量的数据,效果还是很不错的,但是数据量一大,每次查询都会把所有数据扫描一次,查询速度就会明显下降,也就是 数据越多,需要比较的向量越多,计算成本也越高。
这个问题其实和我们普通的数据库很像,数据量大了之后,都会遇到查询变慢的问题。
比如 MySQL 中,如果没有索引,查找数据时可能需要扫描大量记录,建立 B+ 树索引之后,就可以快速缩小查询范围。Elasticsearch 也是类似,通过倒排索引,可以更快地找到包含某些关键词的文档。
一般来讲 我们都会对数据建立索引,索引的本质,就是提前按照某种结构组织数据,让查询时不需要把所有数据都检查一遍。
在实际的大规模向量检索中,通常不会让查询向量和数据库中的所有向量逐一比较,而是会建立专门的向量索引,先快速缩小搜索范围,在查找最近的结果。
这类索引通常会使用 ANN(Approximate Nearest Neighbor,近似最近邻搜索)
这里的 近似 这个词 很关键,它并不是把所有向量都精准的计算一遍,而是通过索引结构,只检查一部分更有可能接近查询向量的数据,就是用少量的精度损失,换去更高的查询速度。
这里常见的索引有 HNSW和IVF
IVF 先找区域,再找数据
IVF的思路 比较容易理解,假设我们现在有100万个向量,IVF会根据向量在空间中的位置,把这100万个向量划分成很多组,比如划分成1000个区域,每一个区域都有这么一个能够代表这一片区域的点,这个点通常叫做聚类中心
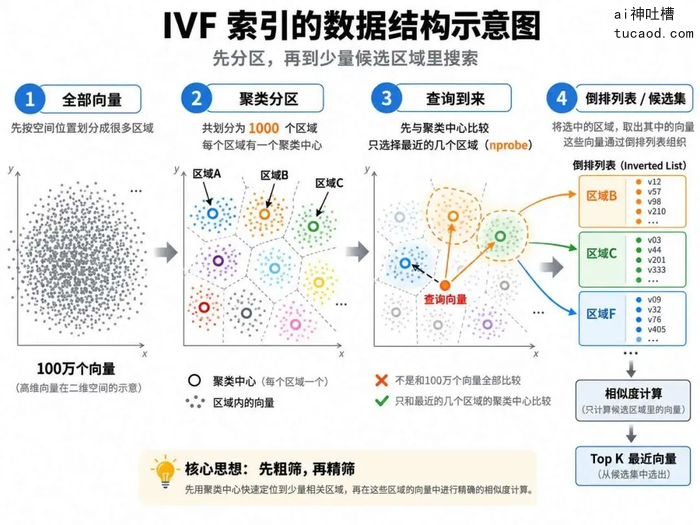
如上图所示,IVF的核心思想,先判断大概在那个区域,再到这个区域里面仔细查找,语义越接近的内容,向量位置通常比较接近,就更有可能被划分到相邻的区域。
查询的时候,到底需要搜索多少个区域,这个是可以调整的
搜索的区域越少,速度越快,但有可能漏掉一些真正相关的数据。
搜索的区域越多,召回率通常会提高,但计算量也会增加。
所以 IVF 本身也是在:
查询速度和搜索精度之间做平衡。
HNSW:把向量组织成一张图
除了分组这种方法之外,还有一种常见的思路,把向量组织成一张图,假设我们数据库中有很多向量,我们可以把每一个向量理解成图里的一个节点,把距离比较近的向量之间建立连接,这样查询的时候,就不需要检查所有节点,而是从一个入口出发,比较附近的点,再沿着更接近问题的方向继续寻找。
HNSW在这个思路上 做了一层优化,他不是只有一张图,而是建立了多图层结构
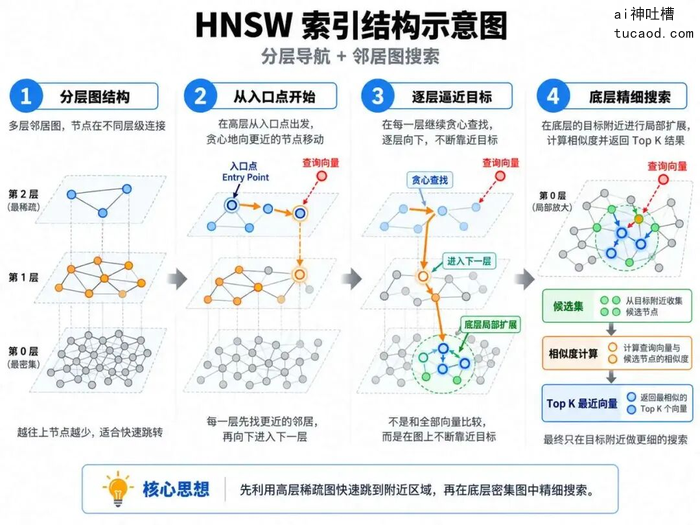
如上图所示,越往上,节点越少,连接跨度越大,越往下,节点越多,搜索也越精细。
查询刚开始的时候,先在最上层寻找,因为上层节点很少,所以可以用很少的几次跳转,快速靠近目标所在的大概区域,等找到一个比较接近的位置之后,再进入下一层继续搜索。
最后进入最底层,在更小的范围内寻找最近的节点。
了解了向量的保存和检索之后,我们在看看业界有哪些现成的处理方法
向量数据库选型
上面我们讲了向量如何保存和检索,也介绍了 IVF、HNSW 这类向量索引。理解这些原理后,我们可以尝试自己实现一个向量检索引擎。但要让它长期服务业务,还得处理并发查询、数据更新、租户隔离、索引构建和维护等问题,每一项都需要投入时间和精力。
有这些需求,市面上也就出现了不同的向量检索方案。大致可以分成四类:专用向量数据库、给传统数据库增加向量能力、给搜索引擎增加向量能力,以及向量检索库。
专用向量数据库:Milvus、Qdrant、Weaviate、Pinecone
这一类系统围绕向量的写入、索引、过滤和查询提供服务。下面把产品横向放在一起,按同一组问题逐项比较:
Milvus 是目前比较典型的开源向量数据库,它最大的特点是从架构上就考虑了大规模数据和分布式扩展,
它既有单机部署方式,也有分布式部署方式,当数据量和查询负载超过单机承载范围时,可以通过集群扩展。但如果要自己维护分布式集群,还得管理多个服务及其依赖,部署和运维成本也会跟着上来。
Qdrant 值得关注的是带条件的向量检索。每条向量可以带上 Payload,例如租户 ID、部门和文档类型。查询时加上这些条件,就可以在符合条件的内容里找语义相近的片段。企业 RAG 常用的 Metadata Filter + Vector Search,解决的就是只在指定租户或部门的资料里检索这类问题。如果业务经常需要按元数据过滤,Qdrant 可以重点评估是否适用。
Weaviate 的产品思路是把对象数据、关键词索引和向量索引放在同一个 Collection 中,再通过模块接入向量化、重排和生成模型。比如,写入文档时可以调用配置好的模型生成向量,用户查询时,可以结合关键词和向量检索,再按需对结果重排或生成回答。
Pinecone全托管的向量数据库服务,适合想少维护集群、快速上线的团队,但无法自建部署。
传统数据库增加向量能力
这类产品最有代表性的就是:PostgreSQL + pgvector。
PostgreSQL 是一个非常流行的传统关系型数据库,pgvector 是在这个数据库上的一个扩展,并不是一个独立的向量数据库。
安装并在数据库中启用 pgvector 后,PostgreSQL 就有了 vector 字段类型,以及向量距离计算和索引能力。假设向量模型输出 768 维,一个企业知识库的表可以这样建:
CREATE EXTENSION IFNOTEXISTS vector;

CREATETABLE document_chunk (
    id BIGSERIAL PRIMARY KEY,
    tenant_id BIGINTNOTNULL,
    department_id BIGINT,
    document_id BIGINTNOTNULL,
    contentTEXTNOTNULL,
    embedding vector(768),
    created_at TIMESTAMPTZ DEFAULTnow()
);
这里的 embedding 是我们自己起的列名,vector(768) 才是 pgvector 提供的类型,表示这一列保存 768 维向量。其他列仍使用 PostgreSQL 原有的字段类型。这样业务数据和向量数据就可以放在同一个 PostgreSQL 中。
这是 pgvector 最大的优势。事实上很多企业 RAG 并没有想象中那么大的数据量。
例如:
-
10 万份文档
-
切分以后 100 万个 Chunk
-
查询并发几十到几百。
对于这种规模,一个已经非常成熟的 PostgreSQL 加上 pgvector,往往就足够了。
更重要的是,企业知识库通常存在大量业务关系:
-
用户,部门,权限,租户,标签,项目,文档等。
如果使用 pgvector,就可以继续使用 PostgreSQL 原有的 SQL、JOIN、事务和权限模型。
不需要再维护:PostgreSQL+Vector Database 两个完全不同的数据系统。
pgvector 支持哪些索引?
pgvector 目前比较重要的 ANN 索引主要是: HNSW 和 IVFFlat。
HNSW 通常查询性能和召回率比较好,但索引本身会占用更多内存,构建速度也更慢。
IVFFlat 的索引相对轻一些,但需要调整 lists、probes 等参数,在速度和召回率之间做取舍。
如果你的业务刚好保存在PostgreSQL数据库中,并且数据量不是特别大的情况下使用 pgvector 扩展也是一个非常不错的选择
搜索引擎增加向量能力
另外一条路线是 Elasticsearch 和 OpenSearch。
它们原本就不是向量数据库,而是搜索引擎,但现在都已经增加了 Vector Search 和 Semantic Search。
这类方案最大的优势,是:
关键词搜索和向量搜索可以在同一个系统里完成。
对于企业搜索来说,这一点非常重要,如果公司本来就有 Elasticsearch 集群,已经用来做:
-
文档搜索;
-
商品搜索;
-
日志搜索;
-
企业搜索。
现在只是希望增加语义搜索能力,那很多时候没必要为了 RAG 再单独部署 Milvus。
直接继续使用 Elasticsearch,反而会让架构简单很多。
FAISS 向量检索
FAISS 经常和 Milvus、Qdrant 放在一起比较,但它并不是数据库,FAISS 是 Meta 开源的向量相似度搜索库。前面讲过的 IVF、HNSW 等索引,在 FAISS 中都有相应实现。我们可以在程序里用它建立索引、写入向量,再查找与问题向量最接近的结果,它擅长做的是:
给我很多 Vector,然后快速找到距离 Query Vector 最近的一批 Vector。
例如,企业知识库已经把文档切成很多段,并生成了向量。应用把这些向量和对应的编号交给 FAISS,用户提问时,应用先把问题转成向量,FAISS 返回最接近的几个编号和距离,应用再根据编号取回原文。
FAISS 可以把索引保存成文件,之后再加载。但原文和租户、部门等业务字段放在哪里,查询前如何检查权限,文档更新后怎样同步索引,以及如何对外提供稳定的查询服务,都需要应用在 FAISS 之外安排。
如果已经有自己的数据存储和服务,只想在程序中加入向量检索,或者需要比较不同索引的效果,FAISS 很合适。如果希望直接使用一套长期运行的数据库服务,还要一起处理业务数据、过滤和运维,就应该考虑前面介绍的数据库方案。
结语
回到开头的问题:
如何从大量信息中,找到和当前问题最相关的那一小部分内容?
向量检索提供了一种很重要的解决思路,我们先通过 Embedding 模型,把原本难以直接计算的文字转换成向量,让语义相近的内容在向量空间里更加接近。
当数据量比较小时,可以直接计算查询向量和所有向量之间的相似度。但当数据增长到百万、千万甚至更大规模之后,逐条比较的成本就会越来越高,这时候就需要 IVF、HNSW 这类向量索引,通过 ANN 近似最近邻搜索,更快地找到可能最相关的结果。
而当向量检索真正进入业务系统之后,我们面对的问题又不只是“怎么找到最近的几个向量”。
向量从哪里来、原文存在哪里、如何更新和删除向量、怎么按照租户和权限过滤、索引如何维护、数据量增长以后怎么扩展,这些都需要一套完整的工程方案来处理。
这也是为什么会出现 Milvus、Qdrant、Weaviate、Pinecone、pgvector、Elasticsearch 等不同的向量检索方案。
它们解决的核心问题大体相同,但在数据规模、索引能力、元数据过滤、分布式能力、部署方式和运维成本上做出了不同取舍。
我们在选择向量检索方案的时候,最终还是要看业务场景。
- 一文讲清向量搜索:RAG 检索的核心原理与选型
- 向量搜索入门:Embedding 模型如何让语义检索成为可能
- 什么是向量数据库?从相似度计算到 IVF 与 HNSW 索引
- RAG 检索原理详解:关键词失效后向量如何找到最相关内容
- 向量相似度计算:余弦相似度、点积与欧氏距离怎么选
- IVF 与 HNSW 索引原理:百万级向量如何快速近似最近邻
- 向量数据库选型:Milvus、Qdrant、Weaviate、Pinecone 对比
- pgvector 实用场景:PostgreSQL 加向量能力到底够不够用
- Elasticsearch 向量搜索:关键词与语义检索如何一体化
- FAISS 是什么?向量检索库与向量数据库的区别
- 系统讲解向量搜索原理:从关键词检索失效讲起,解释 Embedding 模型如何把文字转换成多维向量,让语义相近的内容在向量空间中距离更近,彻底搞懂 RAG 检索的核心机制与实现路径。
- 向量到底怎么表示?从二维三维到多维坐标,768 维向量意味着什么,计算机如何通过距离、夹角和点积比较文本语义,一篇文章建立完整的向量思维直觉。
- 余弦相似度、点积、欧氏距离 L2 三种相似度计算详解,各自适用场景是什么,为什么文本 Embedding 场景中余弦相似度最常用,看懂向量间的接近程度如何衡量。
- 百万级向量如何快速找到最近的十个?IVF 先分区域再精搜、HNSW 多层图逐层逼近,两种 ANN 索引的原理、参数取舍与适用规模,一次讲清楚。
- 向量数据库选型四类路线横向对比:Milvus、Qdrant、Weaviate、Pinecone 专用库,pgvector 扩展,Elasticsearch 向量能力与 FAISS 检索库的差异。
- 企业知识库该用 pgvector 还是专用向量数据库?从数据规模、元数据过滤、JOIN 事务、权限模型到运维成本,给出按业务场景分流的务实判断。
- 已有 Elasticsearch 集群要不要为 RAG 单独部署 Milvus?关键词搜索与向量搜索一体化的优势与架构简化思路,适合企业搜索场景的向量能力增强路径。
- FAISS 不是数据库而是检索库:适合已有数据存储、只想在程序里加入向量检索的团队,但原文、权限、更新同步都要自己在应用层安排。
- 向量检索进入业务系统后真正的工程问题:向量从哪里来、原文存在哪里、如何更新删除、按租户权限过滤、索引维护与水平扩展的完整方案。
- 从 Embedding 原理到向量数据库选型,一篇系统教程搞懂向量搜索全链路:语义距离直觉、ANN 索引取舍与四类方案对照,RAG 开发者入门必读。