「当模型开始不值钱,AI 真正的铲子股变了」
吐槽解读这一期最值得注意的不是开源模型能不能赢,而是它输赢都无所谓——企业把任务分流给不同模型之后,「换模型」变成一件可以随时做、代价也很低的事,于是议价权从模型层转移到了管模型的那一层:谁能记账,谁能看住权限,谁能拦住一次越权调用,谁就掌握了企业 AI 的总开关。
换句话说,开源真正挤掉的是「模型层的不可替代性」,而不是模型本身。当最强模型变成可替换的后端,稀缺的往往是那些替换不掉的东西——企业多年的审批链、权限表、审计日志和已经付过费的数据库。这些东西在模型降价的时候不会跟着便宜。
这一期白线主播 Minta 聊的是一个争议很大的问题:开源模型究竟能不能打败 OpenAI 和 Anthropic?企业的实际应用正在给出一个不同的答案。开源模型未必需要成为能力最强的「全能冠军」,只要能承接一部分成本敏感、适合本地部署或涉及数据主权的任务,就能为企业带来选择权——而选择权本身就是一种稀缺品。
开源模型不需要打败 OpenAI,只需要先进工作流被调用
本期节目从企业采用多模型架构出发。这里的判断不是「谁的能力更强」,而是「谁被真正接进了生产流程」。一个模型哪怕在榜单上不是第一,只要它能稳定承接某类任务、并且成本可接受,就已经完成了它的商业闭环。
全文要点速览
| 关键环节 | 发生了什么 | 为什么关键 |
|---|---|---|
| 成本账 | 同一套工作流跑开源模型,成本优势约 16.4 倍 | 便宜到能批量铺开,才谈得上「够用」这件事 |
| 速度账 | 代价是任务速度慢约三倍 | 说明它适合低价值批量任务,不适合关键路径 |
| 推手 | 芯片商与数据平台比模型公司更积极 | 它们卖的是可替换性本身,不与模型争胜负 |
| 云平台 | 从模型经销商变成企业 AI 的操作系统 | 多套合同与权限无法分开管理,必然收归统一入口 |
| 数据工作流 | 模型可换,审批链与权限表不可换 | 客户黏性来自多年积累,不来自模型能力 |
| 安全可观测 | Agent 会选错模型、越权读取、反复重试烧钱 | 企业必须能回答「这次调用用了谁、花了多少」 |
| 边缘网络 | CDN 从内容分发升级为 AI 流量的路由层 | 延迟、费用、密钥和数据边界都要在这一层管 |
| 价值归属 | 产业链价值从模型层向算力、云、数据、安全、网络转移 | 模型商品化之后,收租的位置变了 |
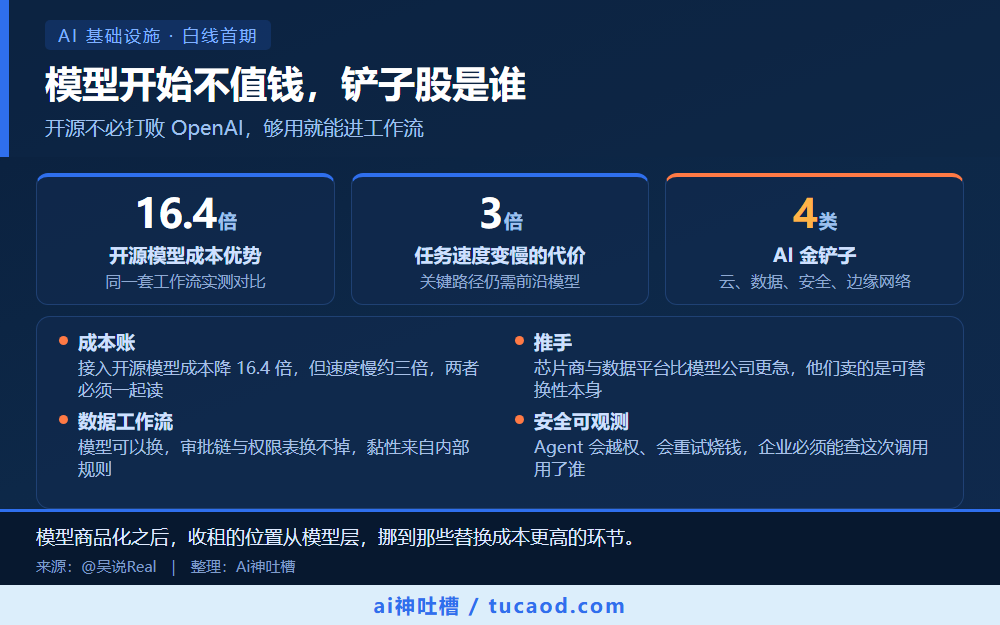
支撑这个判断的是 Chamath 在 All-In Podcast 分享的一项测试。8090 Industries 把一套负责拆分任务、准备上下文、调用工具和检查结果的 Software Factory,分别与 Claude 和开源模型组合使用。为 Claude 加上这套工作流后,成本和速度均有所改善;换到开源模型一侧,成本优势达到约 16.4 倍,代价是任务速度慢约三倍。
| 对比项 | 接入 Claude | 接入开源模型 | 差值含义 |
|---|---|---|---|
| 成本 | 加上工作流后有所改善 | 优势约 16.4 倍 | 批量任务可以大规模铺开 |
| 速度 | 加上工作流后有所改善 | 慢约三倍 | 关键路径仍需留在前沿模型 |
| 结论 | 两者不是替代关系,而是按任务价值分层的分工 | ||
这两个数字必须放在一起读。单独说 16.4 倍,会得出「开源模型更划算」的结论;单独说慢三倍,会得出「开源模型不够用」的结论。合在一起的含义是:任务需要被分级。批量、低风险、延迟不敏感的任务可以交给便宜模型,高价值、高风险、必须快速返回的任务继续留在前沿模型上。DeepSeek 的开源与定价抉择 之所以能被反复当作参照,正是因为它把「分级」做成了可配置的产品能力,而不是让企业自己去猜。
对企业来说,这套分层带来的实际收益有三层:第一是成本,同样一笔业务量可以铺到更大的任务范围;第二是数据,敏感数据可以留在本地部署的模型里,不必为了用一个更强的模型而全部外传;第三是议价权,当换模型的代价足够低,供应商就很难用「你离不开我」来抬高价格。
芯片商与数据平台,比模型公司更急着推开放模型
值得观察的组合,是芯片生态与 Palantir 这类企业数据平台。这两方的立场和模型公司并不相同。芯片商提供芯片、推理软件和开放模型;数据平台则通过 AIP、Ontology、Foundry 和 Apollo,处理企业数据、权限、审计和实际部署。
芯片商推开放模型的动机很直接:如果模型层被少数强势客户控制,芯片和软件生态的使用范围就会被锁死。模型越多、越容易替换,芯片的调用量反而越大——这是卖铲子的逻辑,不是争王座的逻辑。英伟达押注 CUDA 生态的来龙去脉 里的 CUDA 生态正是这套逻辑的最终形态:当年押错路线也没有放弃,与其说是因为英伟达判断准,不如说是它把开发者留在了自己的栈上。国产 GPU 四小龙的路线分歧 则从供给侧说明同一件事的另一面——算力供给的自主路线,最终也会反过来影响模型层的定价能力。
数据平台的诉求恰好相反,也更保守:它要保留企业的模型选择权,让底层模型可以随时更换,但数据、权限和工作流必须继续留在自己的平台上。换句话说,模型是可以被替换的中间层,而它自己要做那个不可替换的层。两边的诉求不同,指向的却是同一件事:模型层的可替代性正在被当作商品来卖。
不过这条路线的成立有一个前提:开放模型必须能大规模进入生产环境,并在可靠性和成本上支撑关键任务。目前大多数开放模型仍停留在「够用但不精确」的位置,一旦涉及资金计算、合规判断这类不容出错的环节,企业还是会回到最贵的那一档。短期内更现实的形态不是全面替换,而是按任务分层共存——这也是上一章那组 16.4 倍与三倍差速必然会长期存在的原因。
多模型时代的四把「AI 金铲子」,从分发到记账各占一层
云平台:企业 AI 的「模型超市」
企业同时使用多家模型后,很快会发现一件麻烦事:很难分别为每一家去管理合同、权限、日志、芯片和数据库。更现实的做法是通过一家云平台统一调用前沿模型、开源模型和自研模型。
这个转变改变了云平台的收入结构。模型公司主要赚模型层那一段收入,而云平台有机会获得对象存储、数据库、安全、日志和开发工具的整笔账单。云平台未来的角色,将从「模型经销商」转向企业 AI 的模型超市和操作系统——它不必是最强模型的持有者,只需要是所有模型对外的统一入口。
数据与工作流:模型可以换,流程很难换
模型并不了解企业内部的客户记录、审批规则和权限体系。ServiceNow、Palantir、Snowflake 和 Databricks 这类平台,负责的正是把企业数据和真实工作流喂给 AI。
模型供应商可以更换,但企业多年积累的权限和流程很难替换。这是四把铲子里最不易被颠覆的一把:模型逐渐商品化之后,粘住客户的就不再是模型能力,而是那些模型根本看不见的内部规则。模型降价不会让审批链变便宜,也不会让历史数据自动获得权限。大厂 AI 算力资本开支的实战账 里的资本开支曲线可以作为侧面印证:钱持续流向算力和平台侧,而不是被模型层单独吸走。
安全与可观测性:AI 黑箱带来的新增量
Agent 可能选错模型、调用错误工具、越权读取数据,或者因反复重试产生高额费用。企业必须能回答几个非常具体的问题:这一次请求用了哪个模型、调了哪些工具、为什么失败、有没有浪费和越权。
Datadog 已经推出 GPU Monitoring、MCP Server 和 Bits AI Security Agent 等产品,目标是把传统监控从服务器扩展到 GPU、模型和 Agent。AI 系统越复杂,企业对安全和可观测性的需求就越强——这部分支出的增长,是由复杂性本身驱动的,而不是由某个模型的热度驱动的。Agent 弹性计算与调度 展示了 Agent 侧的调度复杂度如何快速上升,这类复杂度最终都会变成可观测性的刚需。
CDN 与边缘网络:AI 流量的交通警察
Agent 会在多个模型、数据库和工具之间频繁调用,企业需要统一管理延迟、费用、API 密钥和数据安全。CDN 因此可能从内容分发平台,升级为AI 流量的路由层。
Cloudflare 已经在内部使用混合模型架构:复杂任务继续交给前沿模型,轻量和成本敏感的任务则迁移到 Workers AI 上的开放模型。它的机会不只是获得更多流量,而是控制请求进入哪个模型、花了多少钱、如何缓存和回退,以及数据能否离开特定地区。Fastly 和 Akamai 也在向计算、安全和推理基础设施转型,方向一致:把「传输层」升级为「决策层」。数据中心缺电的现实约束 提示了一个现实约束——推理和训练都会压在同一个电网约束上,而这恰恰是边缘节点距离用户最近的地方。
开源模型正在重新分配产业链的价值,而不只是重新分配模型
开源模型不需要取代 OpenAI 和 Anthropic。前沿模型仍然会掌握能力上限,并获得最复杂、最有价值的任务。这一点在可见的几年内不会改变。
开源模型只需要在足够多的任务中达到「够用」的水平,就能让企业获得选择权。当模型可以被替换之后,产业链上真正稀缺的东西会转移到别的环节:
- 英伟达 希望控制算力和软件栈,靠的是调用量而不是模型排名。
- 云平台 希望控制模型入口和云账单,靠的是统一管理无法拆分的合同与权限。
- ServiceNow 与 Palantir 希望控制企业权限和工作流,靠的是模型看不见的内部规则。
- Datadog 希望控制监控和安全,靠的是 AI 复杂性带来的新增支出。
- Cloudflare 希望控制流量路由和边缘推理,靠的是离用户最近的那一跳。
这张名单里没有模型公司,并不是偶然。模型层是唯一一个每年都会被重新定价、并且定价权不在自己手里的环节。而上面五个位置,共同的护城河都是「替换成本高」:换掉芯片生态要重写推理栈,换掉数据平台要重训一套权限模型,换掉监控等于放弃历史可比数据,换掉边缘节点要重建全球网络。
需要提醒的是,开源模型之争最终可能不会产生一个绝对赢家,它真正带来的变化是把原本集中在模型层的价值,重新分配给算力、云、数据、工作流、安全和网络这六个环节。对企业来说,这份重排清单的实际用法是判断杠杆落在哪一层——AI 算力泡沫与万亿债务 里那笔压在基础设施上的债务,最终要么被真实需求消化,要么由跑不动的项目来偿付。与此同时,大模型上下文与推理能力 展示的另一面是,模型能力的天花板还在快速抬升。但天花板越高,越不会属于模型公司自己。
写在最后
模型变便宜是这一轮几乎所有人都同意的前提,真正没被算清楚的是:当模型不再是瓶颈,企业到底会把预算挪到哪一层。这份名单也许不完整,但方向值得盯——凡是替换成本高于替换收益的环节都在收租,凡是被降价直接削掉的环节都在让位。把这张表反过来读,就是下一轮基础设施叙事的风险清单。
文丨白线 WhiteLine
- 开源模型不必打败OpenAI,只要承接成本敏感、需本地部署或涉数据主权的任务,就能改变AI产业链的价值分配。本文按成本、推手、云平台、数据工作流、安全可观测、边缘网络六层逐节拆解。
- 芯片商推开放模型是为扩大生态调用量,数据平台推开放模型是为保住模型可换、数据不可换。本文分析英伟达与Palantir的共同立场,以及这条路线的可靠性前提。
- 多模型时代真正稀缺的是四类基础设施:统一调用的云平台、替换不掉的数据与工作流、由复杂性驱动的安全可观测、以及升级为决策层的CDN与边缘网络。
- 8090 Industries的测试显示,同一套Software Factory接入开源模型后成本优势约16.4倍,代价是速度慢约三倍。本文说明这两个数字为什么必须一起读。
- 开源模型之争不会产生绝对赢家,真正被重新分配的是产业链价值。本文梳理算力、平台、权限、监控、路由五个位置的护城河来源。
- Chamath在All-In Podcast分享的测试,把开源模型的成本优势和速度短板同时摆了出来。本文用任务分层的思路解释企业该如何配置模型组合。
- Agent在多模型、数据库与工具之间频繁调用,让CDN从内容分发升级为AI流量路由层。本文分析控制请求归属、费用、缓存与数据边界的价值。
- Agent可能选错模型、调用错误工具、越权读取数据或反复重试烧钱,企业必须能回答这次调用用了谁、花了多少。本文说明可观测性支出的增长来源。
- 企业同时使用多家模型后,合同、权限、日志与数据库无法分开管理。云平台因此从模型经销商转向企业AI的模型超市与操作系统,收入结构随之改变。
- 当模型变成可替换的后端,稀缺的就转移到管模型的那一层:谁能记账、谁能看住权限、谁能拦住越权调用,谁就掌握企业AI的总开关。